DeepSeek Buka Kode DeepInfer untuk Mendukung Pemrosesan Model AI pada Berbagai Chip

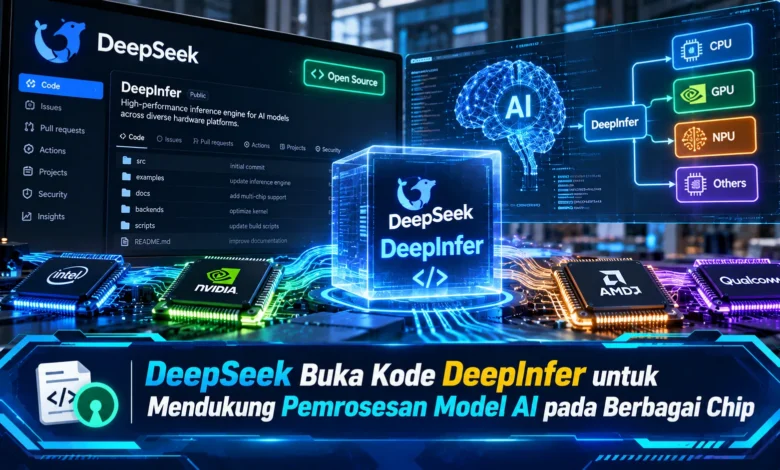
DeepSeek kembali menarik perhatian industri kecerdasan buatan setelah membuka kode sumber DeepInfer pada 20 Oktober 2026. Framework inferensi ini dirancang untuk membantu menjalankan model AI berskala besar dengan lebih efisien, terutama pada infrastruktur yang menggunakan jenis chip berbeda. Dalam rilis awalnya, DeepInfer mendukung GPU Nvidia berarsitektur SM100 serta NPU Huawei Ascend 950. Langkah tersebut memperlihatkan upaya DeepSeek memperluas pilihan perangkat keras tanpa mengabaikan kebutuhan performa dan efisiensi komputasi. Perkembangan TEKNOLOGI ini membuka peluang bagi pengembang dan perusahaan untuk mempelajari sistem inferensi yang digunakan dalam layanan DeepSeek, sekaligus memahami tantangan penerapannya pada pusat data modern.
Apa Itu DeepInfer dan Mengapa Penting bagi Pengembang AI?
DeepSeek mengembangkan DeepInfer sebagai perangkat lunak inferensi berkinerja tinggi yang dirancang untuk mendukung pemrosesan model pada infrastruktur pusat data. Jika dibandingkan dengan proses pelatihan model yang menggunakan data untuk menyesuaikan bobot jaringan, inferensi berkaitan dengan penggunaan model untuk menghasilkan keluaran. Dalam proses inferensi, sistem harus mengolah input dan menghasilkan respons secara efisien. DeepInfer dirancang untuk mengelola proses tersebut secara terdistribusi. Dengan pendekatan ini, DeepSeek memberikan alternatif bagi pengembang infrastruktur AI.
Langkah publikasi sumber terbuka DeepInfer menjadi perkembangan penting dalam ekosistem perangkat lunak AI. Kode tersebut tersedia melalui GitHub menggunakan lisensi Apache 2.0. Ketentuan sumber terbuka tersebut memberikan ruang pengembangan lanjutan sesuai persyaratan lisensi yang berlaku. Framework yang baru dirilis ini memanfaatkan pengalaman pengelolaan layanan AI DeepSeek untuk mengoptimalkan pemrosesan model pada infrastruktur nyata. Walaupun telah digunakan dalam lingkungan DeepSeek, rilis publiknya masih memiliki batasan dibandingkan sistem internal lengkap. Oleh sebab itu, pengembang perlu mempelajari fitur yang telah tersedia.

DeepInfer Mendukung GPU Nvidia dan NPU Huawei Ascend
Salah satu keunggulan utama adalah kompatibilitas dengan platform komputasi Nvidia dan Huawei. Pada rilis sumber terbuka pertama, DeepInfer dapat digunakan pada akselerator Nvidia berarsitektur SM100 dan chip pemrosesan kecerdasan buatan Ascend 950. Kompatibilitas awal ini menunjukkan pengembangan yang tidak hanya berfokus pada satu vendor. Dalam pengembangan sistem AI modern, ketergantungan terhadap perangkat keras tertentu menjadi salah satu tantangan penerapan. Dengan framework tersebut, DeepSeek mendukung pengembangan pada beberapa ekosistem komputasi. Walaupun konsepnya mendukung berbagai chip, penggunaan tetap terbatas pada perangkat yang didukung secara resmi.
Variasi teknologi akselerator menimbulkan kebutuhan penyesuaian perangkat lunak. GPU Nvidia menggunakan ekosistem CUDA untuk mengelola berbagai pekerjaan matematika AI. Di sisi lain, Huawei Ascend mengandalkan lingkungan komputasi CANN yang dirancang untuk akselerator Ascend. Perbedaan tersebut memerlukan penyesuaian kernel dan dependensi. Karena itu, kemampuan lintas chip tidak berarti kode mesin selalu sama. Pengembang tetap perlu menilai dukungan pustaka yang diperlukan sebelum menggunakan framework secara luas.
Teknologi DeepInfer untuk Meningkatkan Kecepatan Inferensi AI
Sistem inferensi DeepSeek tersebut memanfaatkan berbagai teknologi percepatan model seperti FlashMLA, DeepGEMM, DeepEP, dan TileKernels. Komponen tersebut membantu mengoptimalkan pekerjaan matematika model. Komponen pengolahan attention FlashMLA berkaitan dengan optimasi mekanisme attention, sedangkan DeepGEMM menangani komputasi matriks berkecepatan tinggi. Di sisi komunikasi, DeepEP digunakan untuk kebutuhan komunikasi antarproses. Melalui perpaduan optimasi kernel, framework dapat meningkatkan pemanfaatan akselerator. Walaupun pustaka tersebut dirancang berkinerja tinggi, hasilnya dipengaruhi perangkat keras serta jenis pekerjaan.
Sebagai pelengkap pemrosesan model, DeepInfer mengintegrasikan mekanisme pembagian pekerjaan melalui attention data parallelism, context parallelism, serta mixture-of-experts expert parallelism. Berbagai bentuk paralelisme ini memungkinkan pekerjaan didistribusikan pada infrastruktur dengan banyak chip. Untuk sistem yang menggunakan berbagai expert, hanya sejumlah expert dipilih untuk token tertentu. Sebagai bagian dari optimasinya, sistem mengintegrasikan mekanisme distribusi pekerjaan antar-expert agar pekerjaan tidak terkonsentrasi pada perangkat tertentu. Selain itu, DeepInfer mendukung pengaturan pekerjaan tanpa menunggu secara berlebihan untuk mengurangi jeda antara penjadwalan CPU dan eksekusi perangkat. Pendekatan pemrosesan tersebut menjadi fondasi inferensi berskala besar.
Fitur Speculative Decoding dan Output Terstruktur DeepInfer
Teknologi optimasi yang turut disediakan DeepInfer adalah mekanisme pembangkitan token spekulatif. Teknik percepatan ini membantu meningkatkan kecepatan pembangkitan token dengan menghasilkan kandidat token untuk diperiksa. Dalam implementasi DeepInfer, tersedia metode DSpark bersama confidence-scheduled verification untuk mengoptimalkan pemeriksaan token spekulatif. Pendekatan tersebut membantu mempercepat keluaran model pada konfigurasi yang sesuai. Namun demikian, efektivitasnya tidak selalu sama. Karena itu, pengujian performa tetap diperlukan berdasarkan karakteristik penggunaan model.
Untuk mendukung keluaran yang lebih terkontrol, tersedia fitur structured outputs yang memungkinkan pembatasan format respons. Berkat mekanisme keluaran terstruktur, model mampu mengikuti pola ekspresi reguler berdasarkan aturan yang disediakan pengembang. Dukungan format khusus mendukung penggunaan AI pada sistem otomatis yang mengandalkan struktur informasi tertentu. Untuk menggambarkan manfaatnya, aplikasi pengelolaan dokumen berpeluang menggunakan keluaran dengan struktur baku berisi ringkasan informasi. Berkat pengendalian susunan respons, proses integrasi berpotensi menjadi lebih sederhana. Walaupun formatnya terkontrol, akurasi informasi tidak otomatis terjamin sebelum diterapkan pada proses produksi.
Persyaratan Instalasi DeepInfer untuk Pengembang AI
Untuk memulai eksperimen menggunakan DeepInfer perlu menyiapkan lingkungan komputasi yang sesuai. Menurut persyaratan yang tersedia, DeepInfer membutuhkan sistem operasi Linux, Python 3.12, serta GCC versi 13 atau lebih baru. Untuk akselerator Nvidia, lingkungan memerlukan CUDA 13. Sementara itu, implementasi Ascend membutuhkan CANN 9.2. Setelah persyaratan terpenuhi, pengembang bisa mengunduh proyek melalui GitHub. Dalam proses instalasi, lingkungan komputasi perlu disesuaikan melalui variabel DEEPINFER_ACCELERATOR dengan nilai nvidia atau ascend. Langkah konfigurasi tersebut memastikan sistem memilih backend yang sesuai.
Ketika framework selesai dikompilasi, pengguna dapat menjalankan contoh inferensi offline. Pada rilis saat ini, DeepInfer secara resmi mendukung DeepSeek-V4.1-Flash. Berkas model terkait dapat dimuat dari sumber checkpoint yang kompatibel, dengan kebutuhan perangkat keras yang harus diperhitungkan. Kendati teknologinya dikembangkan untuk layanan skala besar, rilis sumber terbuka belum menyediakan seluruh sistem penyajian layanan online. Beberapa bagian penting mencakup penyimpanan cache untuk pemrosesan berkelanjutan, arsitektur pemrosesan terpisah untuk berbagai tahap inferensi, serta penyeimbangan beban pada replika data parallel. Oleh sebab itu, pengembang harus menyiapkan komponen pendukung.
Peluang DeepInfer Mendorong Komputasi AI yang Lebih Fleksibel
Keputusan DeepSeek membuka kode framework ini berpotensi memengaruhi perkembangan infrastruktur AI. Kompatibilitas pada dua platform perangkat keras menunjukkan bahwa optimasi lintas vendor semakin penting. Selama ini, pemilihan perangkat keras sering dipengaruhi ekosistem perangkat lunak. Jika dukungan DeepInfer berkembang, pengembang berpotensi mempunyai lebih banyak pilihan. Meski peluangnya menarik, kinerja pada setiap arsitektur harus dibandingkan secara objektif. Faktor seperti latensi layanan, kapasitas pemrosesan, efisiensi penggunaan energi, serta biaya operasional pusat data.
Di samping aspek kompatibilitas chip, publikasi kode DeepInfer mendukung penelitian terhadap sistem pemrosesan terdistribusi. Peneliti berpeluang mempelajari implementasi kernel, menganalisis efisiensi perangkat keras, serta berkontribusi pada penyempurnaan proyek. Melalui ketentuan sumber terbuka tersebut, pemanfaatan kode dapat dilakukan sesuai lisensi. Walaupun kode tersedia secara terbuka, kebutuhan sumber daya tetap menjadi tantangan. Model besar dapat memerlukan banyak akselerator. Oleh sebab itu, organisasi harus menilai kesiapan infrastrukturnya sebelum menggunakan DeepInfer secara luas.
Perkembangan TEKNOLOGI AI melalui Framework Terbuka DeepInfer
Pembukaan kode sumber DeepInfer memberikan kontribusi baru dalam pengembangan infrastruktur model bahasa besar. Dengan dukungan GPU Nvidia SM100 dan NPU Huawei Ascend 950, DeepInfer membuka pilihan arsitektur komputasi yang lebih beragam. Perpaduan teknologi percepatan komputasi, paralelisme, speculative decoding, dan keluaran terstruktur mendukung pengembangan layanan kecerdasan buatan. Meski framework ini menjanjikan, rilis publik belum mencakup seluruh komponen produksi. Dengan mempertimbangkan batasan ini, pengembang perlu memahami kebutuhan sistem secara menyeluruh. Dalam perkembangan TEKNOLOGI modern, DeepInfer mendorong pengembangan perangkat lunak AI yang lebih terbuka. Menurut Anda, apakah perangkat lunak inferensi lintas akselerator akan membantu perusahaan memilih infrastruktur lebih efisien? Sampaikan pandangan Anda mengenai pengembangan inferensi AI sumber terbuka.